

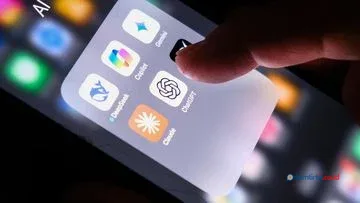
Perusahaan riset kecerdasan buatan (AI) terkemuka, Anthropic, baru-baru ini melayangkan tudingan serius terhadap raksasa teknologi Tiongkok, Alibaba. Anthropic menuduh Alibaba secara tidak sah menggunakan model AI generatif mereka, Claude, hingga 151 juta kali. Penggunaan masif ini diduga bertujuan untuk membantu pengembangan model AI milik Alibaba sendiri, Qwen. Laporan yang sama juga menyebut nama perusahaan AI lain seperti DeepSeek dan Moonshot, mengindikasikan adanya potensi masalah yang lebih luas dalam praktik penggunaan data di industri AI.
Tuduhan Penggunaan Data Tanpa Izin dan Implikasinya
Tuduhan dari Anthropic ini menyoroti isu krusial mengenai hak kekayaan intelektual dan etika dalam pengembangan kecerdasan buatan, khususnya model bahasa besar (LLM). Angka 151 juta kali penggunaan bukanlah jumlah yang sepele; ini menunjukkan skala penggunaan yang sistematis dan masif, jauh melampaui apa yang bisa dianggap sebagai penggunaan wajar atau pengujian biasa. Dalam konteks pengembangan AI, “menyedot” atau “scraping” data dari model lain dapat berarti berbagai hal, mulai dari mengekstrak output model untuk melatih model sendiri, hingga menganalisis arsitektur atau respons model secara mendalam untuk mereplikasi kemampuannya.
Model AI seperti Claude dikembangkan melalui investasi besar dalam riset, data pelatihan, dan sumber daya komputasi. Data pelatihan yang digunakan untuk membangun model ini seringkali merupakan aset paling berharga bagi perusahaan AI, karena kualitas dan keragaman data sangat menentukan kemampuan dan kinerja model. Jika sebuah perusahaan lain menggunakan output atau data dari model kompetitor untuk melatih modelnya sendiri tanpa izin, ini dapat dianggap sebagai pelanggaran hak cipta, pelanggaran syarat layanan, atau bahkan pencurian kekayaan intelektual. Hal ini tidak hanya merugikan perusahaan pemilik model asli secara finansial, tetapi juga merusak insentif untuk berinovasi dan berinvestasi dalam riset AI yang mahal.
Also Read
Alibaba, melalui model Qwen-nya, merupakan pemain kunci dalam lanskap AI global, khususnya di pasar Tiongkok yang sangat kompetitif. Jika tuduhan ini terbukti benar, hal ini dapat menimbulkan konsekuensi hukum yang signifikan bagi Alibaba, termasuk denda besar dan kerusakan reputasi. Lebih dari itu, insiden ini berpotensi memicu perdebatan yang lebih luas tentang bagaimana batasan etika dan hukum harus diterapkan dalam perlombaan pengembangan AI yang semakin intensif, di mana setiap perusahaan berusaha untuk menciptakan model yang paling canggih dan serbaguna.
Latar Belakang dan Konteks Industri AI
Kecerdasan buatan generatif, yang diwakili oleh model seperti Claude dari Anthropic dan Qwen dari Alibaba, telah menjadi salah satu bidang teknologi paling revolusioner dalam beberapa tahun terakhir. Model-model ini mampu menghasilkan teks, gambar, kode, dan konten lainnya yang sangat mirip dengan buatan manusia, membuka peluang baru di berbagai sektor. Namun, di balik kemampuan luar biasa ini, terdapat tantangan besar terkait data. Pelatihan model AI membutuhkan akses ke volume data yang sangat besar, dan seringkali data ini berasal dari berbagai sumber, termasuk internet publik, basis data berlisensi, dan bahkan output dari model AI lain.
Anthropic sendiri adalah perusahaan yang didirikan oleh mantan anggota tim OpenAI, dengan fokus pada pengembangan AI yang aman dan bermanfaat. Model Claude mereka dikenal karena kemampuannya dalam penalaran, pemahaman konteks, dan keamanan. Di sisi lain, Alibaba adalah konglomerat teknologi multinasional yang memiliki ambisi besar di bidang AI, dengan Qwen sebagai salah satu produk unggulannya. Persaingan antara perusahaan-perusahaan ini untuk mendominasi pasar AI sangat ketat, mendorong mereka untuk mencari cara tercepat dan paling efektif untuk meningkatkan kemampuan model mereka.
Penyebutan DeepSeek dan Moonshot dalam laporan yang sama mengindikasikan bahwa masalah penggunaan data tanpa izin mungkin bukan insiden terisolasi, melainkan cerminan dari tantangan yang lebih luas dalam industri AI. Banyak perusahaan rintisan dan raksasa teknologi berlomba-lomba untuk melatih model mereka dengan data terbaik, dan terkadang batas antara penggunaan yang sah dan tidak sah menjadi kabur. Ini menimbulkan pertanyaan tentang perlunya kerangka kerja regulasi yang lebih jelas dan standar etika yang disepakati secara global untuk mengatur praktik pengumpulan dan penggunaan data dalam pengembangan AI.
Kasus ini juga menyoroti kompleksitas dalam menentukan kepemilikan dan hak cipta atas output yang dihasilkan oleh AI, serta data yang digunakan untuk melatihnya. Apakah output dari sebuah model AI dapat dianggap sebagai kekayaan intelektual yang dilindungi? Bagaimana jika model tersebut dilatih sebagian menggunakan output dari model lain? Pertanyaan-pertanyaan ini masih menjadi perdebatan sengit di kalangan pakar hukum, etika, dan teknologi. Tanpa kejelasan yang memadai, insiden serupa kemungkinan besar akan terus muncul, menghambat kolaborasi dan inovasi yang sehat di sektor AI.
Tuduhan Anthropic terhadap Alibaba ini merupakan pengingat penting akan perlunya transparansi dan akuntabilitas dalam pengembangan AI. Hasil dari kasus ini tidak hanya akan mempengaruhi kedua perusahaan yang terlibat, tetapi juga akan membentuk preseden penting bagi seluruh industri AI. Ini akan memaksa para pengembang dan regulator untuk lebih serius mempertimbangkan bagaimana data, kekayaan intelektual, dan etika harus dikelola di era kecerdasan buatan, demi memastikan pertumbuhan teknologi yang adil, berkelanjutan, dan bertanggung jawab.